Aide
En trois étapes
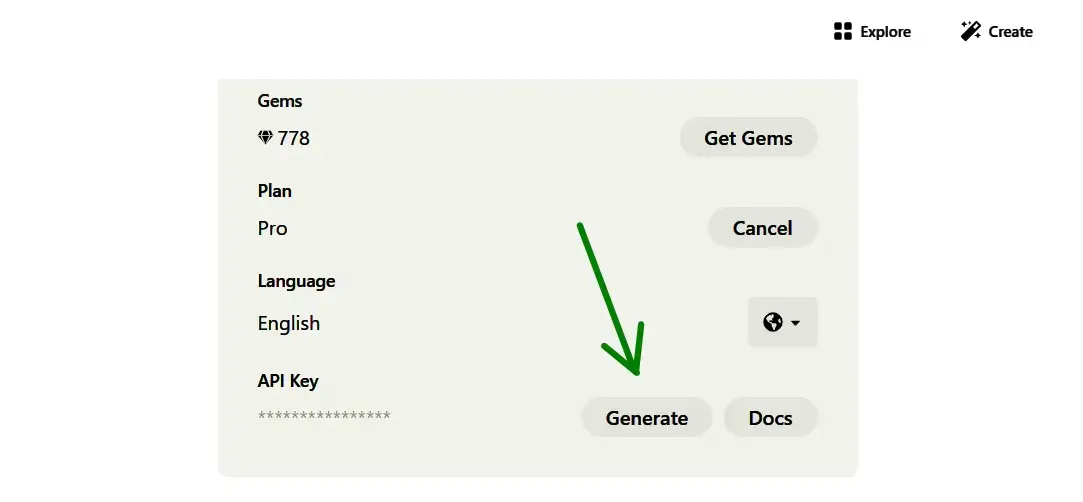
Colle-la dans les Paramètres
Dans le jeu : Paramètres → modèles API → colle la clé.
C’est prêt — joue !
Clic sur un personnage — sandbox, « Nouvelle partie » — histoire.
Le cœur et le cerveau du jeu
Sans modèle de texte, pas de jeu. L’API, c’est la façon dont le jeu « parle » à un réseau de neurones distant via internet, à l’aide d’une clé. Pour choisir vite : pour commencer gratuitement — Gemini (avec une limite) ou OpenRouter (les modèles gratuits sont marqués free:) ; qualité quasi sans censure — Claude ; moins cher et pour expérimenter — Grok.


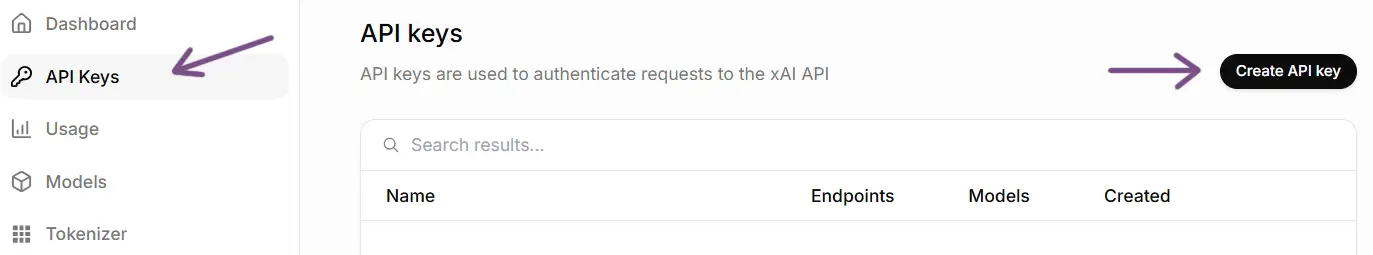

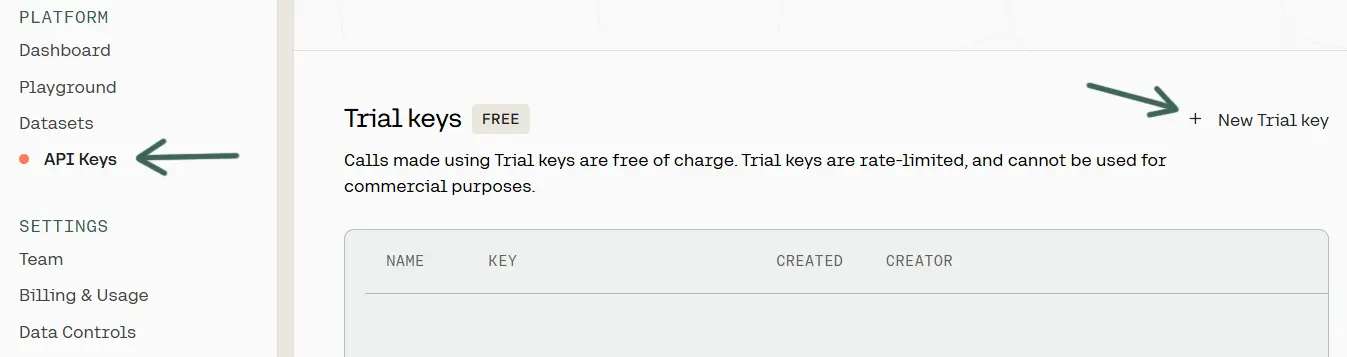
📋 Pas à pas pour chaque fournisseur
Gemini. aistudio.google.com → Get API key → Create API key → copie-la dans les Paramètres.
OpenRouter. openrouter.ai → Keys → Create Api Key → définis un nom/une limite → copie-la.
Claude (Anthropic). console.anthropic.com → API Keys → Create Key → alimente ton solde dans billing.
OpenAI. platform.openai.com → roue dentée en haut à droite → API keys → Create new secret key → alimente ton solde dans billing.
Grok (xAI). console.x.ai → API Keys → Create API key → Manage-Billing.
Groq. console.groq.com → Keys → Create API Key → billing.
Cohere. dashboard.cohere.com → API Keys → Trial (gratuit) ou Production (+ billing).
🔧 Subtilités pour obtenir les clés
Gemini. Dans les pays où Gemini est bloqué, il te faut un VPN (idéalement aux États-Unis). Le plus fiable est un compte Google dont la langue principale est « anglais (États-Unis) ». Dans les paramètres du jeu, tu peux saisir plusieurs clés Gemini séparées par des virgules (ne fonctionne pas avec le proxy intégré).
Modèles payants (Claude, OpenAI, Grok, Groq, Cohere). Après avoir créé la clé, alimente ton solde dans l’onglet billing de ton espace fournisseur — sans solde, les requêtes ne passent pas.
Endpoint personnalisé. Dans les paramètres, tu peux connecter n’importe quelle API compatible OpenAI : indique l’URL (https uniquement), la clé (si besoin) et le nom du modèle.
🧠 koboldcpp
Ces modèles n’atteignent pas encore tout à fait la qualité des grands modèles accessibles par API, mais ils ne sont pratiquement pas censurés, sont entièrement gratuits et totalement privés — à choisir si tu te méfies des grandes entreprises, tiens à ta vie privée et ne veux pas payer.
Dans les paramètres, choisis texte → clique sur « koboldcpp » et choisis un modèle
Télécharge un modèle et place-le dans le dossier resources/koboldcpp du jeu, puis choisis dans les paramètres texte → clique sur « koboldcpp » et sélectionne le modèle téléchargé
télécharger koboldcpp → modèles GGUF sur huggingface →
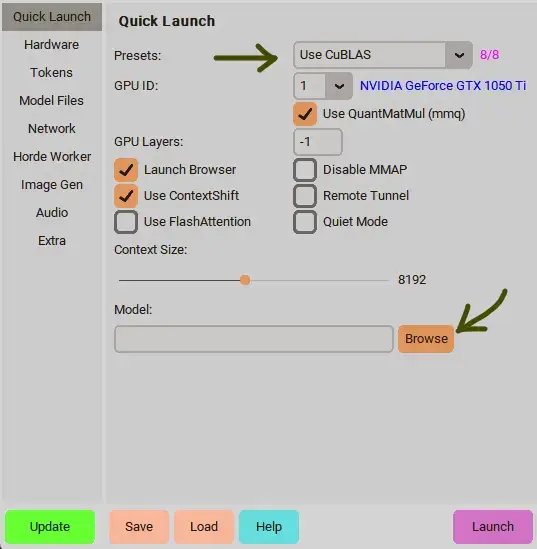
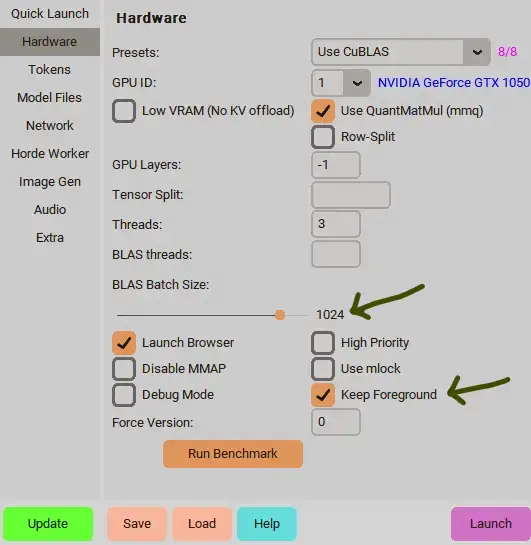
Lancement : koboldcpp → charge un modèle → lance le jeu (choisis « koboldcpp »). Dans le jeu, seul le port 5001 fonctionne (onglet Network). Le bouton console du jeu affiche les logs de koboldcpp. C’est un mode pour ceux qui savent ce qu’ils font ou qui veulent régler finement GPU/CPU.
Modèles recommandés :
- Saiga Nemo 12B Q5_K_M [8.5gb] Mémoire : au moins 16 Go · NVIDIA 3060 (8/12 Go) ou équivalent au minimum
- Qwen3.5-9B-Claude-4.6-HighIQ-THINKING-HERETIC-UNCENSORED Q4_K_M [5.5gb] Mémoire : au moins 12 Go · NVIDIA 2070/2080 (8 Go) ou équivalent au minimum
- MN-CaptainErisNebula-Chimera-v1.1-THINKING-ClaudeOpus4.5-12B-heretic-uncensored i1-Q4_K_M [8.5gb] Mémoire : au moins 16 Go · NVIDIA 3060 (8/12 Go) ou équivalent au minimum
- Gemma-4-31B-StyleTune-heretic-ara i1-Q4_K_M [19.3gb] Mémoire : au moins 32 Go · NVIDIA 4070 (8/12 Go) ou équivalent au minimum
- Qwen3.5-122B-A10B-heretic-v2 i1-Q3_K_M [54.6gb] Mémoire : au moins 64 Go · NVIDIA 4070 (12 Go) ou équivalent au minimum, 16–24 Go c’est mieux · Le savoir d’un 122B, mais seuls 10B travaillent sur chaque mot, donc il répond plus vite que sa taille ne le laisse penser. Idéal pour les longues histoires, les personnages complexes et le lore
📱 koboldcpp-remote
Impossible de faire tourner un modèle local sur un smartphone, mais tu peux jouer sur ton téléphone couplé à un PC puissant — de deux façons :
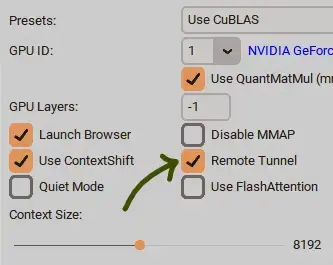
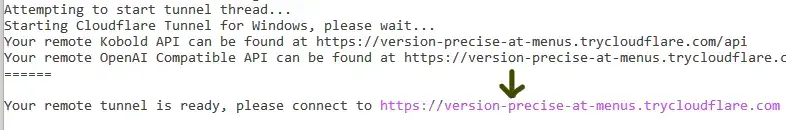
▪ Cloudflare (intégré) : lance koboldcpp → active Remote Tunnel → charge un modèle → sur le téléphone, choisis « koboldcpp-remote » et colle l’URL fournie par kobold.
▪ ngrok : inscris-toi sur ngrok, télécharge le plugin (ngrok + proxy empaquetés) → lance start.bat et colle ton token → lance koboldcpp avec Remote Tunnel désactivé → sur le téléphone, choisis « koboldcpp-remote » et colle l’URL de ngrok.
 Uncensored Local AI android
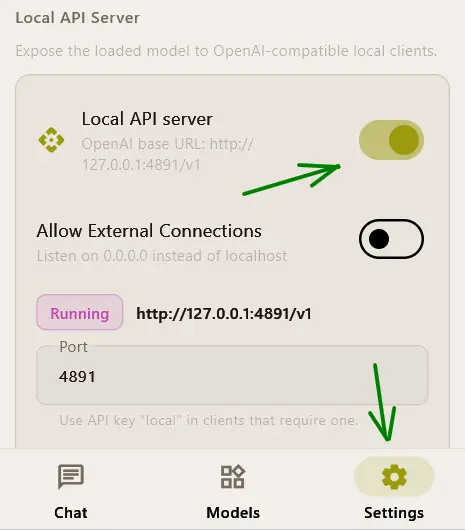
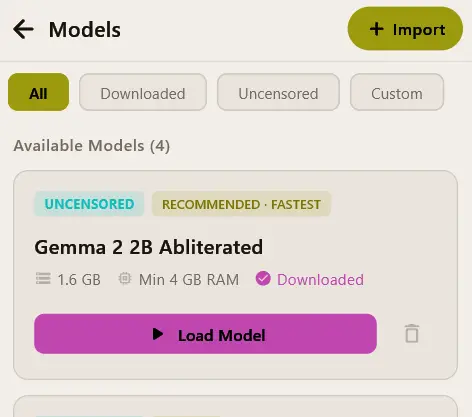
Un modèle local directement sur Android : installe l’application, charge un modèle GGUF et active le local api server. Dans le jeu, choisis « uncensored local ai » et laisse le champ endpoint vide (par défaut 127.0.0.1:4891).
dépôt officiel → app-arm64-v8a-release.apk ↓
🗄 koboldai — l’option historique
Pris en charge, mais déconseillé (koboldcpp est plus pratique). télécharger pour Windows · dépôt et solution pour Linux.
Lance koboldai (local) → charge un modèle → passe en mode « chat » → lance le jeu (choisis koboldai). Fonctionne uniquement sur le port 5000.
Pour vérifier : après avoir envoyé un message depuis le jeu → ouvre le menu « mémoire » dans kobold — le contexte système doit s’y charger dans toute sa splendeur.
Génération d’images
🎨 Stable Diffusion · ComfyUI
Confidentialité maximale et zéro censure. Les modèles d’images locaux n’exigent pas une « méga-machine » et n’ont rien à envier à l’API en qualité (une IA de texte doit garder toute l’intrigue en tête, alors qu’un modèle d’images peint juste une toile par couches — il lui faut donc moins de mémoire). Stable Diffusion/koboldcpp sont déjà dans la build — ou configure ComfyUI à part. Les modèles (*.safetensors, *.gguf) vont dans resources/stablediff/models, les LoRA dans resources/stablediff/lora. Le plus simple pour en trouver, c’est civitai.
Dans les paramètres, choisis images → choisis Stable Diffusion/KoboldCpp ou télécharge et configure ComfyUI séparément → puis sélectionne un modèle
Télécharge un modèle et place-le dans resources/stablediff/models → puis sélectionne-le dans les paramètres images → choisis Stable Diffusion/KoboldCpp ou télécharge et configure ComfyUI séparément → puis sélectionne un modèle
Modèles recommandés :
- iLustMix [6.7gb] Carte graphique : 6–8 go ou plus (nvidia 2060 ou mieux), ram : 16 go ou plus · Anime et illustration 2.5d. Prompt en tags danbooru, compatible avec les LoRA illustrious. Déjà incluse dans le jeu
- Anima [3.8gb] Carte graphique : 6 go ou plus, ram : 16 go ou plus · Modèle anime léger et récent ; comprend les phrases simples et gère bien les scènes à plusieurs personnages. Il faut qwen3-0.6b (t5) et le vae qwen-image dans les champs
- WAI-illustrious-SDXL [6.4gb] Carte graphique : 6–8 go ou plus, ram : 16 go ou plus · Le modèle anime illustrious le plus populaire : anatomie stable, des tonnes de LoRA, prompt en tags
- RealVisXL V5.0 [6.9gb] Carte graphique : 8 go ou plus, ram : 16 go ou plus · Photoréalisme et portraits à la peau naturelle, sfw comme nsfw. Sur une machine modeste, prends la version lightning (4–6 étapes)
- z-image-turbo Q4_K [3.9gb] Carte graphique : 8 go ou plus (6 minimum), ram : 16 go ou plus · Photoréalisme rapide en 8 étapes, comprend les longues descriptions et le texte dans l’image, sans censure. Il faut qwen3-4b (t5) et le vae ae.safetensors de flux dans les champs
- qwen-image-2.1 [4.5gb] Carte graphique : 12 go ou plus (marche avec 8 go, mais ~5 min par image), ram : 32 go ou plus · Suit le prompt mieux que tous : scènes complexes, poses, texte. Lent. Il faut qwen3-vl-8b (t5) et le vae qwen-image-2.1 dans les champs
- Chroma1-HD Q4_K_M [5.6gb] Carte graphique : 12 go ou plus, ram : 32 go ou plus · Sans censure, basé sur flux, tous les styles de la photo à l’art. Lent (~25 étapes). Il faut t5xxl et le vae ae.safetensors de flux dans les champs
Le moyen le plus simple de trouver des modèles et des LoRA est de consulter civitai
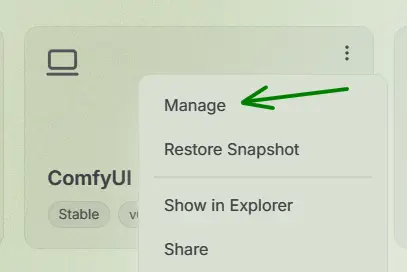
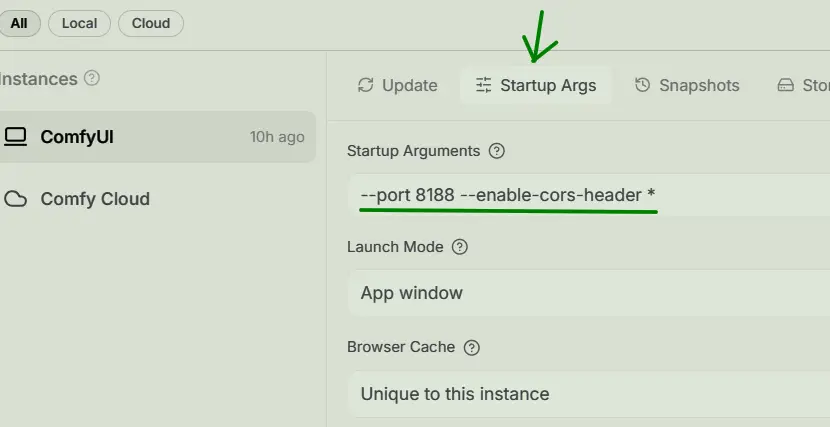
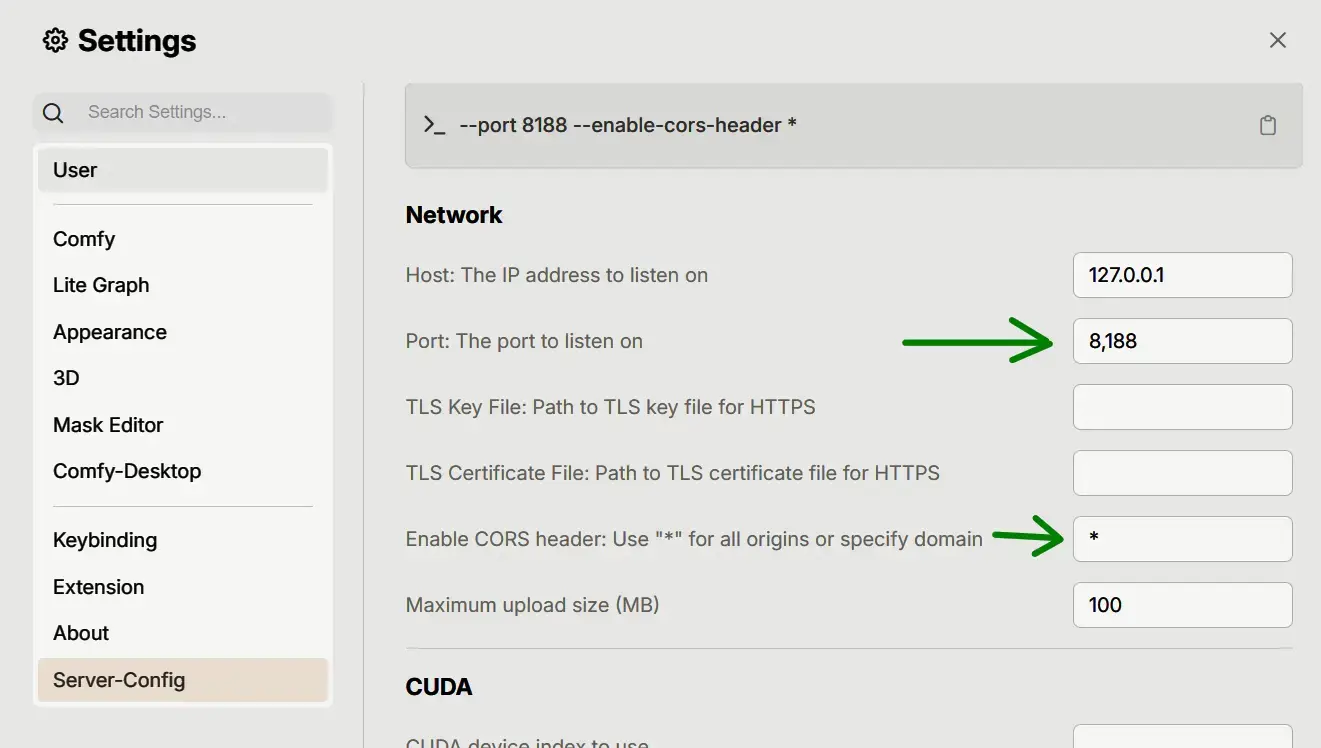
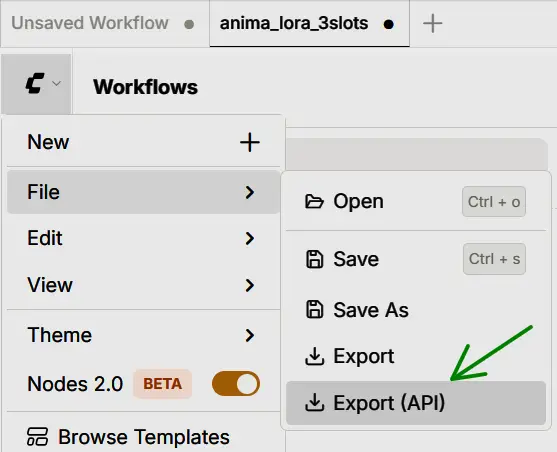
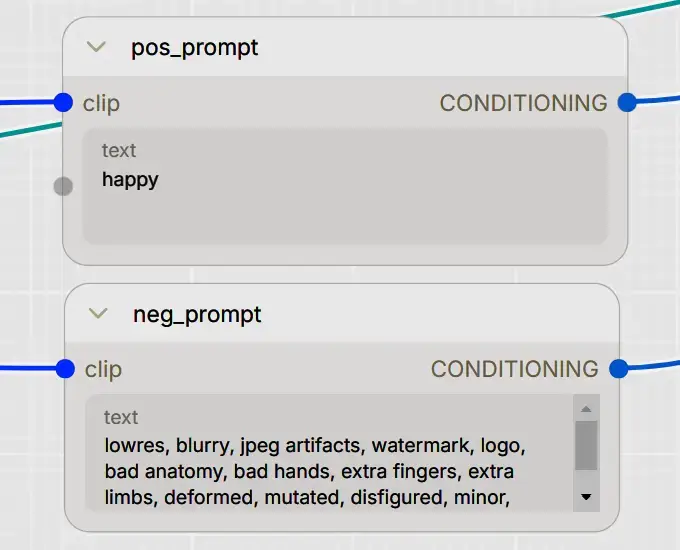
ComfyUI : dans les paramètres de ComfyUI, saisis --port 8188 --enable-cors-header *. Pour que ton workflow fonctionne dans le jeu, renomme les champs de prompt en pos_prompt et neg_prompt → enregistre le json via File → Export (API) et sélectionne-le dans les paramètres du jeu. Des exemples de workflows se trouvent dans resources/comfyui.
Toute la configuration se fait dans ComfyUI. Pour qu’une modification s’applique aux requêtes du jeu, tu dois mettre à jour le fichier JSON du workflow.

✨ Anima dans ComfyUI
Lance ComfyUI → glisse le fichier de workflow .json directement dans la fenêtre de ComfyUI → télécharge les fichiers et range-les dans les bons dossiers :
- anima-base-v1.0.safetensors → ComfyUI/models/diffusion_models/
- qwen_3_06b_base.safetensors → ComfyUI/models/text_encoders/
- qwen_image_vae.safetensors → ComfyUI/models/vae/
- anima-turbo-lora-v0.2.safetensors → ComfyUI/models/loras/
Réglages recommandés pour Anima : avec turbo-lora — steps 8–12, cfg-scale 1, force de la LoRA ~0.7 ; sans turbo-lora — steps 20–30, cfg-scale ~6. Les mêmes valeurs valent pour Anima via koboldcpp. clip-skip n’a aucun effet sur Anima.
⚙️ Paramètres de génération
📝 Champs dans le jeu
🎬 Vidéo (Wan)
Règle le curseur d’images au-dessus de 1 pour transformer la génération en courte vidéo (WebM dans l’application de bureau, GIF dans le navigateur, environ 16 i/s). Fonctionne uniquement avec les modèles vidéo WAN / LTX ; Anima et SDXL ignorent ce réglage. Kit léger pour 8 Go de VRAM :
- Wan2.1-T2V-1.3B-Q8_0.gguf [1.5gb] → resources/stablediff/models
- umt5-xxl-encoder-Q4_K_M.gguf [3.7gb] → t5-xxl
- wan_2.1_vae.safetensors [254mb] → vae
Option de meilleure qualité (très juste avec 8 Go de VRAM), avec le même encodeur UMT5 :
- Wan2.2-TI2V-5B-Q4_K_M.gguf [3.4gb] → resources/stablediff/models
- wan2.2_vae.safetensors [1.4gb] → vae
Model → liste des modèles, encoder → champ t5-xxl, vae → champ VAE, clip-1/clip-2 vides. Attention au VAE : wan_2.1_vae pour 1.3B, wan2.2_vae pour TI2V-5B. Premier essai : 5–13 images, 512×512, environ 20 étapes, CFG scale 5–6. Le style se règle dans le prompt ou avec des LoRA WAN de Civitai
Synthèse et reconnaissance vocales
Les répliques peuvent être doublées (synthèse vocale), et tu peux répondre au personnage à la voix (reconnaissance). Les deux fonctionnent via API ou en local.

⚡ supertonic cpu
Le modèle le plus léger et le plus rapide, supertonic, est inclus dans le build et tourne sur le cpu. Côté qualité, il reste derrière ses grands frères plus lourds, mais il s’en sort plutôt bien, surtout sur les machines modestes. Dans les paramètres, choisis voix → déplie « synthèse vocale » → active supertonic speech et choisis la voix qui te plaît
🎙 qwen3-tts · coqui XTTS-2
Synthèse vocale locale : qwen3-tts (inclus dans la build win-local) ou coqui XTTS-2. Active « synthèse vocale locale » → choisis une voix prête à l’emploi ou clone la tienne — un enregistrement wav de 6 à 15 s, place le fichier dans resources/speech et sélectionne-le dans les paramètres. Pour éviter que le modèle perde du temps à démarrer, un serveur local est utilisé — au premier lancement, le pare-feu Windows te demandera l’autorisation.
Dans les paramètres, choisis voix → déplie « synthèse vocale » → choisis une voix « qwen3-tts » prédéfinie ou clone une voix à partir d’un enregistrement WAV de 6 à 15 secondes. Saisis le texte prononcé dans l’enregistrement : plus il est exact, meilleur sera le clonage
qwen3-tts télécharger ↓ puis décompresse-le dans resources/speech/qwen → sélectionne-le ensuite dans les paramètres voix → déplie « synthèse vocale » → choisis une voix prédéfinie ou importe un extrait WAV pour cloner une voix. Pour obtenir un clone fidèle, saisis aussi précisément que possible le texte prononcé dans le fichier
coqui-tts télécharger ↓ puis place les fichiers dans resources/speech/coqui → sélectionne-les ensuite dans les paramètres voix → déplie « synthèse vocale » → choisis une voix intégrée ou importe ton propre extrait (WAV, au moins 6 s)
💡 Pour un bon clonage, saisis le texte prononcé dans l’enregistrement aussi précisément que possible. Changer de wav de référence peut nécessiter un redémarrage du jeu.
Reconnaissance vocale : la Speech API du navigateur est la plus simple et la plus rapide ; à cause des restrictions de Google pour les applications electron, elle s’ouvre dans le navigateur, alors garde l’onglet ouvert. La reconnaissance locale (whisper ggml) est un peu plus précise, privée et hors ligne, mais plus lente pour l’instant. Avec OpenAI, nous recommandons d’activer les instructions personnalisées de reconnaissance dans les paramètres.
Commandes, contexte et lieux
⌨️ Raccourcis claviers
💡 Contexte
Rédige ton contexte personnalisé sous forme d’instructions et expérimente. Ton contexte sera placé avant celui de base et ne sera utilisé que dans le bac à sable
🟣🟢🔴 Les boutons « effacer le contexte sexy », « effacer le personnage » et « effacer le personnage et le contexte sexy » permettent de retirer certaines parties du contexte système — utilise-les si ton contexte personnalisé entre en conflit avec celui du jeu et si tu veux tout définir toi-même
Les instructions de base ne conservent que les déclencheurs système et un minimum d’informations sur l’apparence du personnage
📍 Lieux
Changement manuel de lieu, disponible dans le bac à sable
Dans le bac à sable, tu peux changer de lieu depuis le menu ; dans l’histoire, cela se fait par le dialogue. Ce système sert aussi d’alternative au jeu sans génération d’images.
Lieux disponibles dans le jeu :
appartement, salle de bains/douche, restaurant/café, jungle/forêt, champ, plage, bibliothèque, désert, métro, lune, magasin/centre commercial, ville, hôpital, parc, club, espace, voiture, chalet/ville/forêt d’hiver, entrepôt/usine abandonné, stade, ruines d’une cité céleste, tour de mage/observatoire antique, caverne de cristal, plateau glacé en montagne, salle BDSM, toit, ville d’hiver, forêt d’hiver, commissariat, prison, canapé, chambre, maison de plage, vaisseau spatial, studio photo, piscine, aéroport, cuisine, salle de classe
Le bot détermine automatiquement, à partir des messages récents, si le lieu a changé. S’il ne le détecte pas, indique-le simplement plus clairement dans le dialogue, par exemple : « le lieu a changé, nous sommes maintenant dans le désert »
Questions fréquentes
Le jeu est-il payant ?
Certains réglages supplémentaires, contextes personnalisés et modes D&D sont accessibles avec un mot de passe (renouvelé environ une fois par mois) — via un abonnement Patreon ou un achat unique sur itch.io
Faut-il internet ?
Mes clés sont-elles en sécurité ?
Où sont stockés mes sauvegardes et mes paramètres ?
multiic-save.json que tu pourras réimporter ensuite. %APPDATA%\Multiic\ ~/Library/Application Support/Multiic/ ~/.config/Multiic/Le modèle ne répond pas / erreur
Le modèle local ne démarre pas
C:\multiic. Évite Program Files, les dossiers système, OneDrive et les dossiers aux droits restreints. Vérifie que les fichiers du modèle ne sont pas en « lecture seule ».Je veux utiliser un KoboldCPP externe
http://localhost:5001.KoboldCPP a choisi la mauvaise carte graphique
Les images sortent censurées
Stable Diffusion, ComfyUI et KoboldCPP — lequel choisir pour les images ?
Où placer les modèles pour la génération locale ?
La génération d’images est très lente
Encore des questions ?
écris sur Discord — une petite communauté sympa t’aidera, et j’essaie moi aussi de répondre souvent. Et merci à tous ceux qui soutiennent le projet 🖤