帮助
三步搞定
粘贴到设置中
在游戏中:设置 → API 模型 → 粘贴密钥。
完成——开玩吧!
点击角色进入沙盒,点击“新游戏”进入剧情。
游戏的心脏与大脑
没有文本模型就玩不了游戏。API 是游戏通过互联网、凭密钥与远程神经网络“对话”的方式。快速选择:想免费开始——Gemini(有额度限制)或 OpenRouter(免费模型带有 free: 标记);想要高质量、几乎无审查——Claude;更便宜、适合尝鲜——Grok。



📋 各服务商分步说明
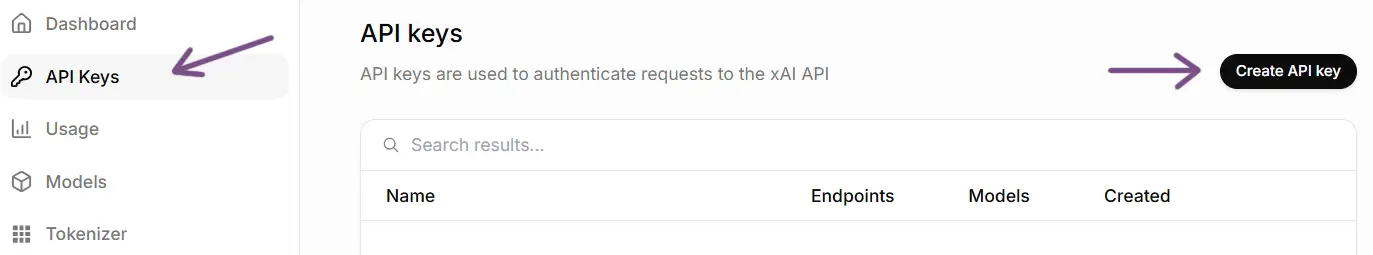
Gemini. aistudio.google.com → Get API key → Create API key → 复制到设置中。
OpenRouter. openrouter.ai → Keys → Create Api Key → 设置名称/限额 → 复制。
Claude (Anthropic). console.anthropic.com → API Keys → Create Key → 在 billing 中充值。
OpenAI. platform.openai.com → 右上角齿轮 → API keys → Create new secret key → 在 billing 中充值。
Grok (xAI). console.x.ai → API Keys → Create API key → Manage-Billing。
Groq. console.groq.com → Keys → Create API Key → billing。
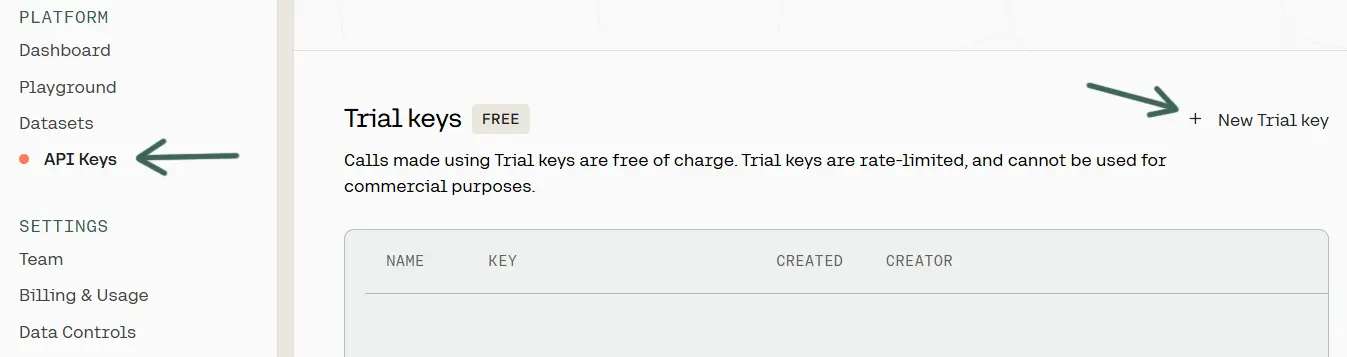
Cohere. dashboard.cohere.com → API Keys → Trial(免费)或 Production(+ billing)。
🔧 获取密钥的注意事项
Gemini. 在 Gemini 被封锁的国家/地区需要使用 VPN(最好是美国节点)。更稳妥的做法是使用主语言为“英语(美国)”的 Google 账号。在游戏设置中,Gemini 可以填写多个用逗号分隔的密钥(使用内置代理时不可用)。
付费模型(Claude、OpenAI、Grok、Groq、Cohere)。 创建密钥后,请在服务商后台的 billing 页面充值——没有余额,请求就无法发出。
自定义 endpoint。在设置中可以接入任何兼容 OpenAI 的 API:填写 URL(仅限 https)、密钥(如需要)和模型名称。
🧠 koboldcpp
本地模型的质量还略逊于大型 API 模型,但几乎没有审查、完全免费,也完全私密。如果你不信任大公司、重视隐私且不想付费,它们很适合你。
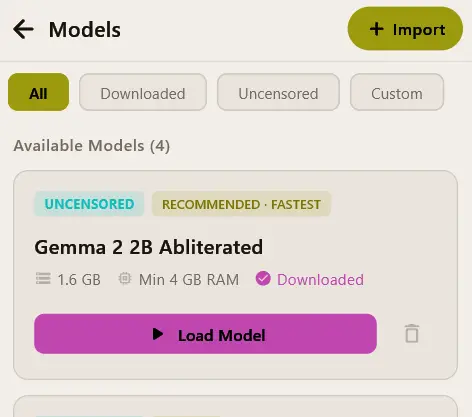
请在设置中选择 文本 → 点击“KoboldCpp”并选择模型
下载模型,放入游戏目录 resources/koboldcpp,然后在设置中选择 文本 → 点击“KoboldCpp”并选择已下载的模型
下载 koboldcpp → huggingface 上的 GGUF 模型 →
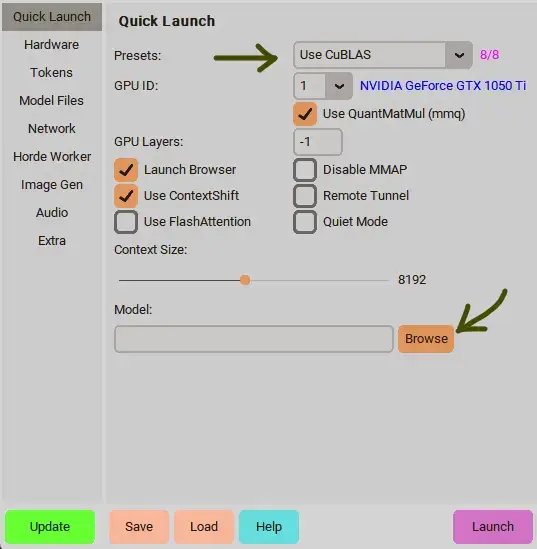
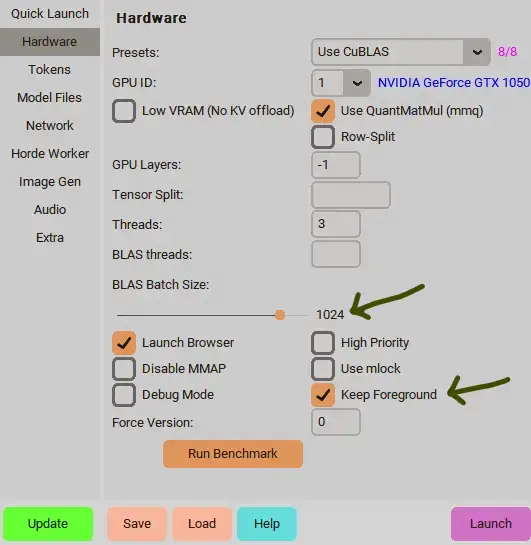
启动:koboldcpp → 加载模型 → 启动游戏(选择“koboldcpp”)。游戏中只支持 5001 端口(Network 选项卡)。游戏里的控制台按钮会显示 koboldcpp 的日志。这个模式适合清楚自己在做什么、或想精细调节 GPU/CPU 的玩家。
推荐模型:
- Saiga Nemo 12B Q5_K_M [8.5gb] 内存:至少 16 GB · NVIDIA 3060(8/12 GB)或同等及以上显卡
- Qwen3.5-9B-Claude-4.6-HighIQ-THINKING-HERETIC-UNCENSORED Q4_K_M [5.5gb] 内存:至少 12 GB · NVIDIA 2070/2080(8 GB)或同等及以上显卡
- MN-CaptainErisNebula-Chimera-v1.1-THINKING-ClaudeOpus4.5-12B-heretic-uncensored i1-Q4_K_M [8.5gb] 内存:至少 16 GB · NVIDIA 3060(8/12 GB)或同等及以上显卡
- Gemma-4-31B-StyleTune-heretic-ara i1-Q4_K_M [19.3gb] 内存:至少 32 GB · NVIDIA 4070(8/12 GB)或同等及以上显卡
- Qwen3.5-122B-A10B-heretic-v2 i1-Q3_K_M [54.6gb] 内存:至少 64 GB · NVIDIA 4070(12 GB)或同等及以上显卡,16–24 GB 更好 · 拥有 122B 的知识量,但每个词只调动其中 10B,因此回复速度比体量看起来快。最适合长篇故事、复杂角色和世界观设定
📱 koboldcpp-remote
手机上无法直接运行本地模型,但可以用手机搭配一台高性能电脑来玩——有两种方法:
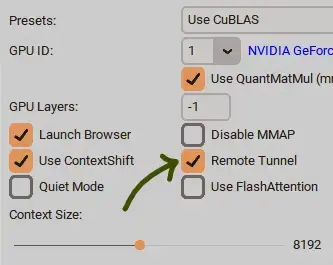
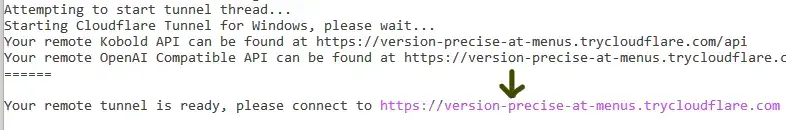
▪ Cloudflare(内置):启动 koboldcpp → 开启 Remote Tunnel → 加载模型 → 在手机上选择“koboldcpp-remote”,粘贴 kobold 给出的 URL。
▪ ngrok:在 ngrok 注册,下载插件(打包好的 ngrok + 代理)→ 运行 start.bat 并粘贴你的令牌 → 在关闭 Remote Tunnel 的情况下启动 koboldcpp → 在手机上选择“koboldcpp-remote”,粘贴 ngrok 的 URL。
 Uncensored Local AI android
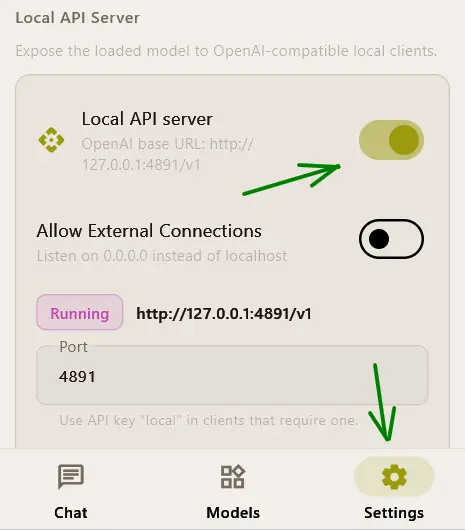
直接在 Android 上运行本地模型:安装应用,加载 GGUF 模型并开启 local api server。在游戏设置中选择“uncensored local ai”,endpoint 一栏留空即可(默认 127.0.0.1:4891)。
官方仓库 → app-arm64-v8a-release.apk ↓
🗄 koboldai——旧方案
仍然支持,但不推荐(koboldcpp 更方便)。Windows 版下载 · 仓库及 Linux 解决方案。
启动 koboldai(local)→ 加载模型 → 设为“聊天”模式 → 启动游戏(选择 koboldai)。只支持 5000 端口。
检查方法:从游戏发送一条消息后 → 在 kobold 中打开“记忆”菜单——系统上下文应该会完整地加载在那里。
图片生成
🎨 Stable Diffusion · ComfyUI
最大程度的隐私,且没有审查。本地图片模型不需要“顶配硬件”,画质也不输 API(文本 AI 要把整个剧情记在脑子里,而图片模型只是一层层地画一张画布——所以需要的显存更少)。Stable Diffusion/koboldcpp 已内置在版本中——也可以单独配置 ComfyUI。模型(*.safetensors、*.gguf)放到 resources/stablediff/models,LoRA 放到 resources/stablediff/lora。在 civitai 上找模型最方便。
请在设置中选择 图片 → 选择 Stable Diffusion/KoboldCpp,或另行下载安装 ComfyUI,再选择模型。
下载模型并放入 resources/stablediff/models,然后在设置中选择。 图片 → 选择 Stable Diffusion/KoboldCpp,或另行下载安装 ComfyUI,再选择模型。
推荐模型:
- iLustMix [6.7gb] 显卡:6–8 GB 起(NVIDIA 2060 或更高),内存:16 GB 起 · 动漫与 2.5D 插画。用 Danbooru 标签写提示词,兼容 Illustrious LoRA。游戏已自带
- Anima [3.8gb] 显卡:6 GB 起,内存:16 GB 起 · 轻量的新动漫模型;能理解普通句子,多角色场景表现好。需要在字段中填入 qwen3-0.6b(t5)和 qwen-image VAE
- WAI-illustrious-SDXL [6.4gb] 显卡:6–8 GB 起,内存:16 GB 起 · 最受欢迎的 Illustrious 动漫模型:人体结构稳定,LoRA 众多,用标签写提示词
- RealVisXL V5.0 [6.9gb] 显卡:8 GB 起,内存:16 GB 起 · 写实照片与人像,皮肤自然,SFW 与 NSFW 都能画。配置较弱时请选 Lightning 版(4–6 步)
- z-image-turbo Q4_K [3.9gb] 显卡:8 GB 起(最低 6 GB),内存:16 GB 起 · 8 步快速出写实图,能理解长描述和图中文字,无审查。需要在字段中填入 qwen3-4b(t5)和 Flux 的 ae.safetensors VAE
- qwen-image-2.1 [4.5gb] 显卡:12 GB 起(8 GB 也能跑,但每张约 5 分钟),内存:32 GB 起 · 最听提示词的模型:复杂场景、姿势、文字。速度慢。需要在字段中填入 qwen3-vl-8b(t5)和 qwen-image-2.1 VAE
- Chroma1-HD Q4_K_M [5.6gb] 显卡:12 GB 起,内存:32 GB 起 · 基于 Flux 的无审查模型,从照片到艺术风格都能画。速度慢(约 25 步)。需要在字段中填入 t5xxl 和 Flux 的 ae.safetensors VAE
寻找模型与 LoRA,最方便的网站是 civitai
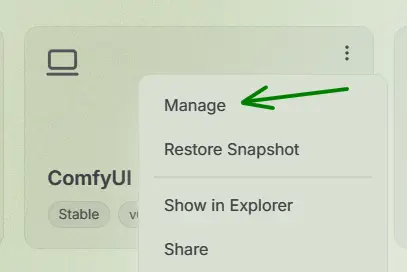
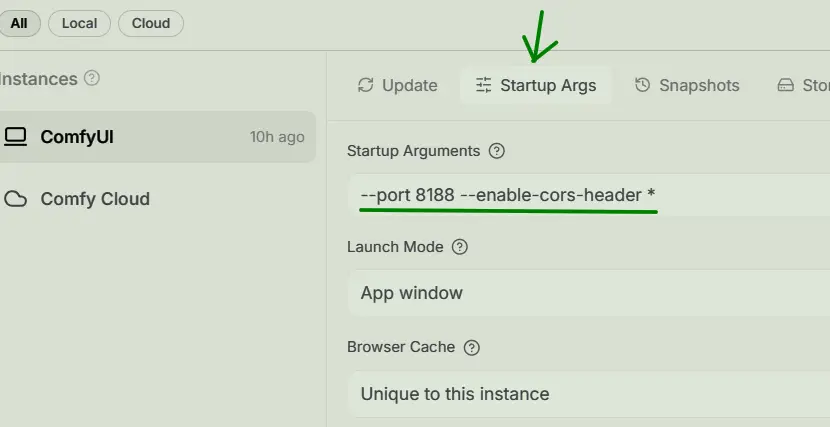
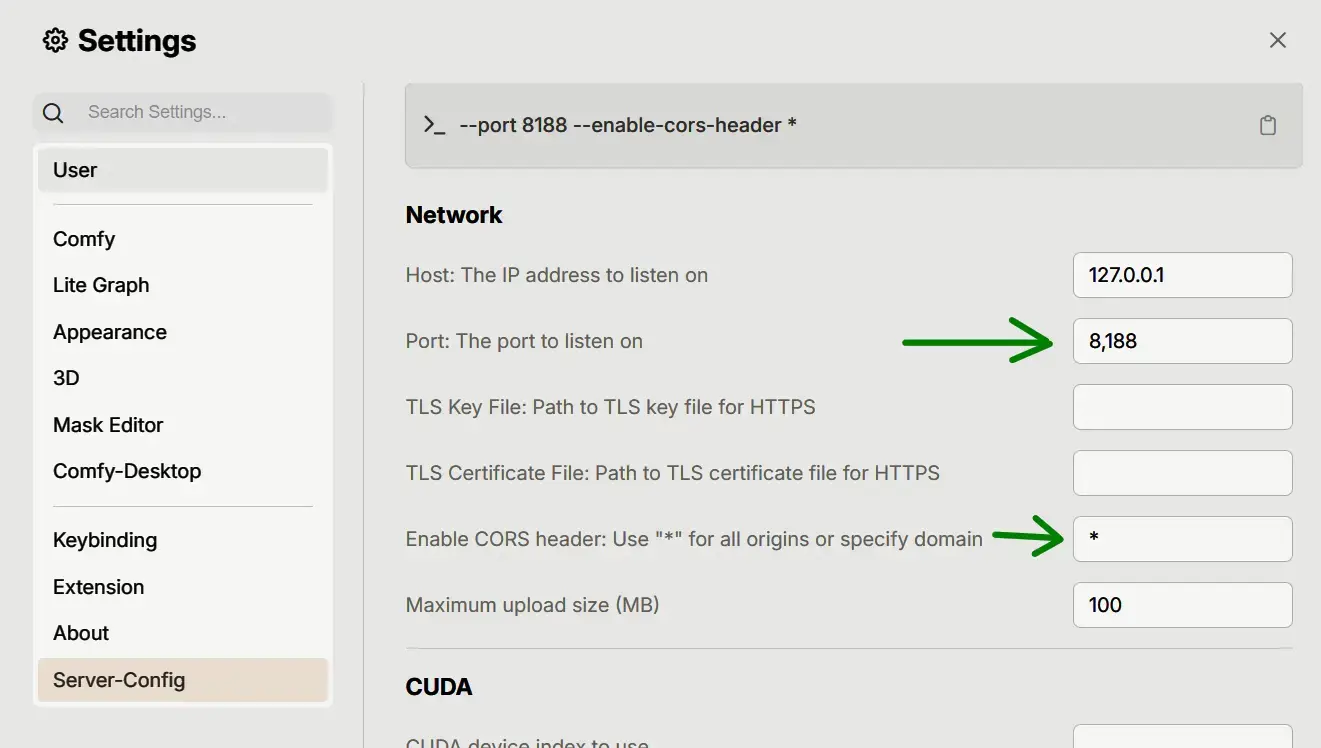
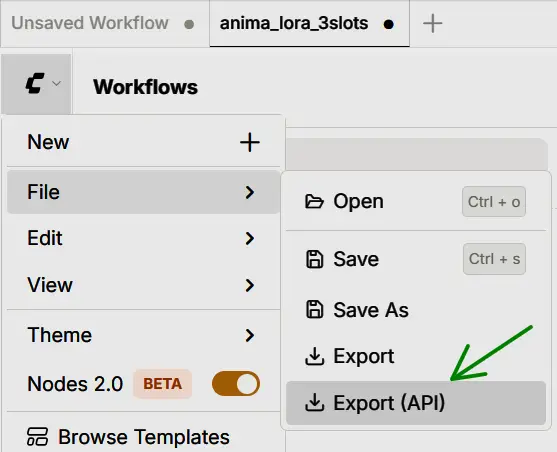
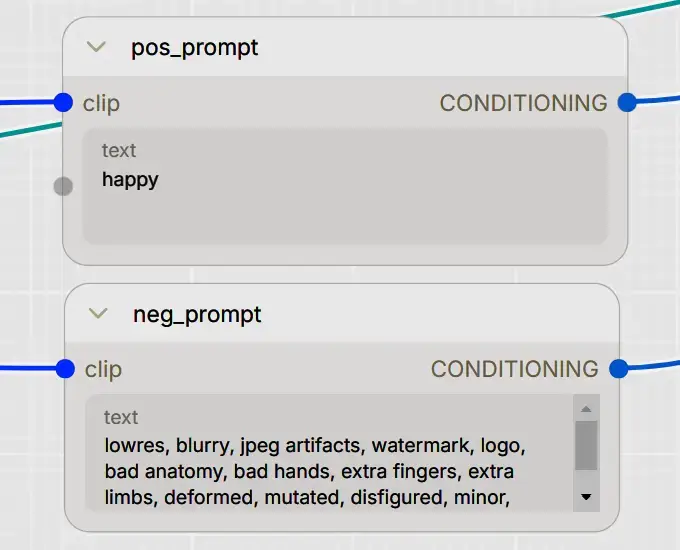
ComfyUI:在 ComfyUI 的设置中填写 --port 8188 --enable-cors-header *。要让你的 workflow 在游戏中生效,请把提示词字段重命名为 pos_prompt 和 neg_prompt → 通过 File → Export (API) 保存 json,并在游戏设置中选择它。workflow 示例位于 resources/comfyui。
所有配置都在 ComfyUI 中完成。 若要让更改影响来自游戏的请求,需要更新工作流 JSON。

✨ Anima 在 ComfyUI 中
启动 ComfyUI → 把 workflow 文件 .json 直接拖进 ComfyUI 窗口 → 下载以下文件并放到对应文件夹:
- anima-base-v1.0.safetensors → ComfyUI/models/diffusion_models/
- qwen_3_06b_base.safetensors → ComfyUI/models/text_encoders/
- qwen_image_vae.safetensors → ComfyUI/models/vae/
- anima-turbo-lora-v0.2.safetensors → ComfyUI/models/loras/
Anima 推荐设置:使用 turbo-lora 时——steps 8–12,cfg-scale 1,LoRA 强度 ~0.7;不使用 turbo-lora 时——steps 20–30,cfg-scale ~6。通过 koboldcpp 运行 Anima 时同样适用。clip-skip 对 Anima 没有影响。
⚙️ 生成参数
📝 游戏内字段
🎬 视频(Wan)
将帧数滑块设为大于 1,即可生成短视频(桌面应用中为 WebM,浏览器中为 GIF,约 16 fps)。仅支持 Wan / LTX 视频模型;Anima 与 SDXL 会忽略帧数。适合 8 GB 显存的轻量套件:
- Wan2.1-T2V-1.3B-Q8_0.gguf [1.5gb] → resources/stablediff/models
- umt5-xxl-encoder-Q4_K_M.gguf [3.7gb] → t5-xxl
- wan_2.1_vae.safetensors [254mb] → vae
质量更高的方案(8 GB 显存会很吃紧),UMT5 编码器相同:
- Wan2.2-TI2V-5B-Q4_K_M.gguf [3.4gb] → resources/stablediff/models
- wan2.2_vae.safetensors [1.4gb] → vae
模型 → 模型列表;编码器 → t5-xxl 字段;VAE → vae 字段;clip-1/clip-2 留空。不要混用 VAE:1.3B 使用 wan_2.1_vae,TI2V-5B 使用 wan2.2_vae。首次尝试:5—13 帧、512×512、约 20 步、CFG Scale 5—6。风格可通过提示词或 Civitai 上的 Wan LoRA 控制。
配音与语音识别
台词可以配音(语音合成),你也可以直接开口回复角色(语音识别)。两者都支持 API 或本地运行。

⚡ supertonic cpu
最轻、最快的模型 Supertonic 已内置于游戏中,在 CPU 上运行。音质不如那些更大的模型,但相当不错,在配置较弱的电脑上尤其合适。请在设置中选择 语音 → 展开“语音合成” → 启用 supertonic speech 并选择喜欢的声音。
🎙 qwen3-tts · coqui XTTS-2
本地语音合成:qwen3-tts(已内置在 win-local 版本中)或 coqui XTTS-2。开启“本地语音合成”→ 选择一个现成的声音,或克隆你自己的声音——录一段 6–15 秒的 wav,把文件放进 resources/speech 并在设置中选中。为了不让模型每次都花时间启动,游戏会使用本地服务器——首次启动时 Windows 防火墙会请求授权。
请在设置中选择 语音 → 展开“语音合成” → 选择预设的 Qwen3-TTS 声音,或使用 6—15 秒 WAV 录音克隆声音。请填写录音中的原文;越准确,克隆质量越高。
qwen3-tts 下载 ↓ 解压到 resources/speech/qwen,然后在设置中选择。 语音 → 展开“语音合成” → 选择预设声音,或上传 WAV 片段克隆声音。若要获得高质量克隆,请尽可能准确地填写录音中的原文。
coqui-tts 下载 ↓ 将文件放入游戏目录 resources/speech/coqui,然后在设置中选择。 语音 → 展开“语音合成” → 选择内置声音,或上传自己的片段(WAV,至少 6 秒)。
💡 想要克隆效果好,请尽可能准确地填写录音中说出的文字。更换参考 wav 后可能需要重启游戏。
语音识别:浏览器自带的 Speech API 最简单、最快;由于 Google 对 electron 应用的限制,它会在浏览器中打开,所以请保持该标签页开启。本地识别(whisper ggml)准确度稍高、私密且可离线,但目前速度较慢。使用 OpenAI 时,建议在设置中开启自定义识别指令。
操作、上下文与地点
⌨️ 快捷键
💡 上下文
自定义上下文请写成指令形式,并多做尝试。它会放在系统上下文开头,仅在沙盒模式中使用。
🟣🟢🔴 使用“清除情色设定”“清除角色”或“清除角色与情色设定”按钮,可以移除部分系统上下文。如果自定义上下文与系统设定冲突,或你想亲自定义一切,就用它们。
基础指令仅保留系统触发器和最少的角色外貌信息。
📍 地点
手动切换地点,仅在沙盒中启用。
沙盒中可从菜单切换地点;剧情模式中则通过对话切换。没有启用图像生成时,地点也可作为玩法变化。
游戏可用地点:
公寓、浴室/淋浴间、餐厅/咖啡馆、丛林/森林、田野、海滩、图书馆、沙漠、地铁、月球、商店/购物中心、城市、医院、公园、夜店、太空、汽车、冬季木屋/城市/森林、废弃仓库/工厂、体育场、天空之城遗迹、法师塔/古代观测站、水晶洞窟、山中冰原、BDSM 房间、屋顶、冬季城市、冬季森林、警察局、监狱、沙发、卧室、海滨小屋、宇宙飞船、摄影棚、游泳池、机场、厨房、教室
机器人会根据最近消息的上下文自动判断地点是否改变。若没有识别出来,可以在与角色的对话中明确写出,例如:“地点变了,我们现在在沙漠。”
常见问题
游戏收费吗?
部分额外设置、自定义上下文和 D&D 模式需要密码解锁(大约每月更新一次)——可通过 Patreon 订阅或在 itch.io 一次性购买获得
需要联网吗?
我的密钥安全吗?
我的存档和设置保存在哪里?
multiic-save.json 文件,之后可以再导入回来。 %APPDATA%\Multiic\ ~/Library/Application Support/Multiic/ ~/.config/Multiic/模型没有回应 / 报错
本地模型无法启动
C:\multiic。不要使用 Program Files、系统文件夹、OneDrive 或权限受限的文件夹。确认模型文件没有被设为“只读”。我想使用外部的 KoboldCPP
http://localhost:5001。KoboldCPP 选错了显卡
生成的图片被审查了
Stable Diffusion、ComfyUI 和 KoboldCPP——生图该选哪个?
本地生成用的模型应该放在哪里?
图片生成非常慢
还有问题?
来 Discord 找我们吧——这个小而友好的社区会帮你解决问题,我自己也会经常回复。感谢所有支持这个项目的人 🖤